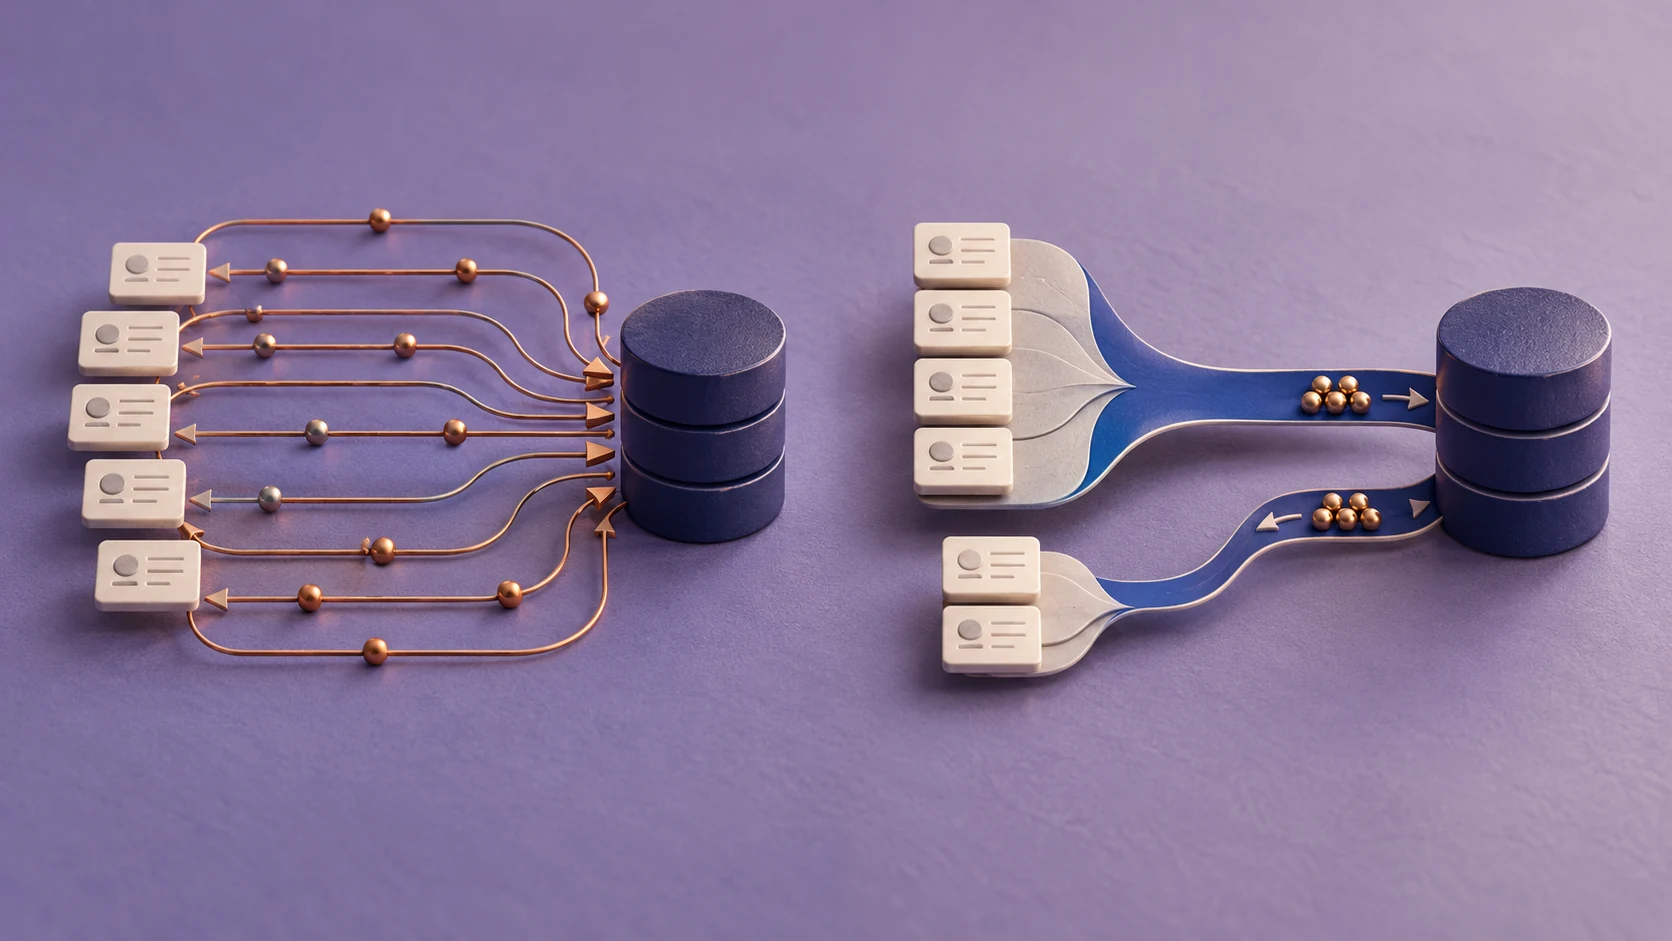
Проблема N+1 появляется, когда после запроса списка приложение отдельно загружает связанные данные для каждой строки. В Django часто помогают select_related для одиночной связи и prefetch_related для набора связанных объектов. Но сначала нужно увидеть реальные SQL-запросы и убедиться, что результат не меняется.
На Mentoring.digital разберём небольшой каталог книг. Примеры рассчитаны на существующий учебный Django-проект: модели добавляются в установленное приложение catalog, а команды с данными выполняются в отдельной тестовой базе.
В catalog/models.py определены автор и книга. У книги один автор, у автора может быть несколько книг:
from django.db import models

class Author(models.Model):
    name = models.CharField(max_length=80)

class Book(models.Model):
    title = models.CharField(max_length=120)
    author = models.ForeignKey(
        Author, on_delete=models.CASCADE,
        related_name="books",
    )
Создайте и примените миграции учебного проекта, затем откройте оболочку:
python manage.py makemigrations catalog
python manage.py migrate
python manage.py shell
Импортируйте Author и Book из catalog.models. В пустую учебную базу один раз добавьте двух авторов и три книги. Повторный запуск этого фрагмента создаст дополнительные записи и изменит результаты подсчёта:
anna = Author.objects.create(name="Anna")
boris = Author.objects.create(name="Boris")
Book.objects.bulk_create([
    Book(title="Python basics", author=anna),
    Book(title="SQL practice", author=anna),
    Book(title="Python tests", author=boris),
])
Это искусственный набор для объяснения механизма. Его не нужно добавлять в рабочую базу продукта.
Подсчитывать запросы нужно вокруг фактического чтения данных. Простое создание QuerySet обычно ещё не обращается к базе. Выполните в оболочке:
from django.db import connection
from django.test.utils import CaptureQueriesContext

with CaptureQueriesContext(connection) as queries:
    rows = [
        (book.title, book.author.name)
        for book in Book.objects.order_by("id")
    ]

print(len(queries))
print(rows)
В нашем локальном запуске на Django 5.2.18 и SQLite получилось четыре запроса: один за тремя книгами и по одному за автором каждой книги. Две книги одного автора всё равно вызвали отдельные обращения через разные объекты Book.
В реальном приложении место обращения может быть спрятано в шаблоне или сериализаторе. Поэтому измеряйте участок, который формирует результат целиком, а не только функцию, возвращающую ленивый QuerySet.
books = (
    Book.objects
    .select_related("author")
    .order_by("id")
)
rows = [(book.title, book.author.name)
        for book in books]
Повторите подсчёт вокруг этого кода. В учебном наборе получился один запрос с соединением таблиц, а список названий книг и имён авторов остался прежним. select_related подходит для ForeignKey и OneToOne-связей; загрузить произвольную коллекцию книг автора этим способом нельзя.
Не вызывайте метод без разбора всех связей «на всякий случай». Укажите данные, которые реально читает данный экран. Широкий JOIN тоже имеет стоимость, и меньшее число запросов не является доказательством меньшего времени ответа.
Теперь задача обратная: вывести авторов и их книги. Для этой связи используем имя books, заданное в модели:
authors = (
    Author.objects
    .prefetch_related("books")
    .order_by("id")
)
rows = [
    (author.name,
     [book.title for book in author.books.all()])
    for author in authors
]
На наших двух авторах обычный обход без prefetch выполнил три запроса. Версия выше выполнила два: за авторами и за их книгами. Django сопоставляет результаты в Python. Это не универсальное обещание двух запросов: вложенные связи, дополнительные обращения и другая структура выборки меняют число.
Предварительная загрузка занимает память. Ограничивайте размер страницы и проверяйте, сколько связанных объектов действительно требуется. Если нужны только агрегаты или отдельные поля, задача может решаться другим запросом без создания полного набора моделей.
После prefetch_related("books") вызов author.books.filter(...) выражает новый запрос, а не простое чтение уже подготовленного набора. В нашем примере фильтрация по названию для каждого автора дала четыре запроса, включая ненужную предварительную загрузку.
Когда заранее известно, какая часть книг нужна, задайте фильтр в Prefetch и сохраните результат в отдельном атрибуте:
from django.db.models import Prefetch

authors = Author.objects.prefetch_related(
    Prefetch(
        "books",
        queryset=Book.objects.filter(
            title__startswith="Python"
        ),
        to_attr="python_books",
    )
)
rows = [
    (author.name,
     [book.title for book in author.python_books])
    for author in authors
]
В локальной проверке этот вариант вернулся к двум запросам и сохранил тот же отфильтрованный результат. python_books здесь является подготовленным списком. Не вызывайте на нём методы QuerySet.
В тесте Django создайте нужные записи до измеряемого блока и используйте новый QuerySet внутри него. Пример фрагмента метода TestCase, в базе которого уже есть три книги:
with self.assertNumQueries(1):
    names = [
        book.author.name
        for book in
        Book.objects.select_related("author")
    ]
self.assertEqual(len(names), 3)
Этот блок также прошёл локальную проверку. Не подставляйте в него QuerySet, который уже был вычислен ранее: его кэш может скрыть обращения и дать ложное впечатление от оптимизации. Вместе с количеством запросов проверяйте сами данные и ожидаемые связи.
Для рабочего проекта повторите измерение на реалистичном размере страницы и оцените время выполнения, объём данных и SQL-план. Наши числа показывают механизм на трёх книгах, а не выигрыш производительности вашего сервиса.
Разобрать скрытую загрузку в шаблоне или сериализаторе можно с наставником по Django. На встречу полезно принести небольшой воспроизводимый набор данных, код формирования ответа и SQL до и после изменения.