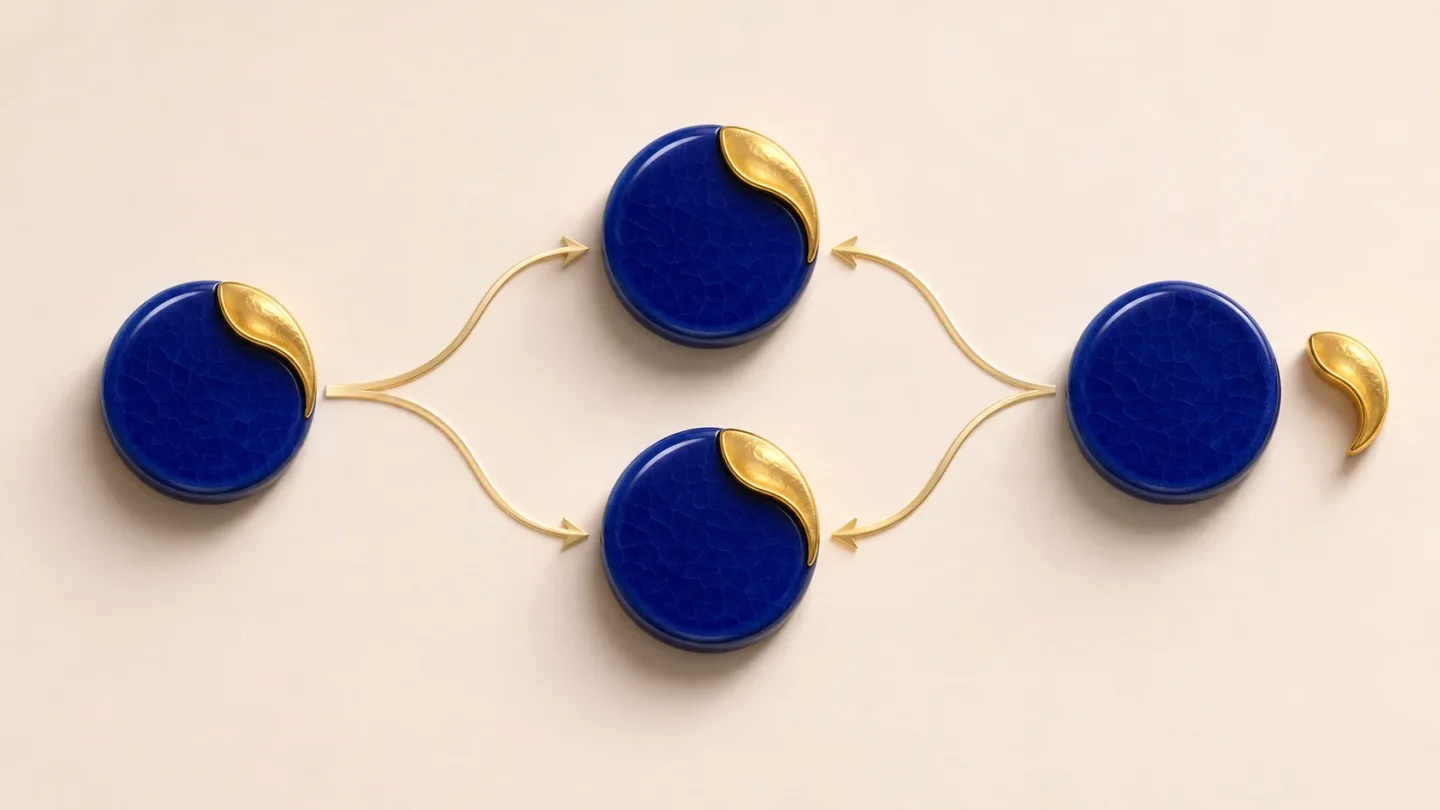
Одинаково выглядящий символ может иметь разные Unicode-представления. В таком случае сравнение через === не обязано вернуть true. В практикуме Mentoring.digital приведём обе строки к одной канонической форме.
В первом литерале буква с акцентом задана одной кодовой точкой. Во втором обычная буква дополнена комбинируемым акцентом. Escape-последовательности позволяют увидеть различие в самом исходном коде.
const composed = "\u00E9";
const decomposed = "e\u0301";

console.log(composed === decomposed); // false
console.log(composed.length); // 1
console.log(decomposed.length); // 2

console.log(
  composed.normalize("NFC") ===
    decomposed.normalize("NFC")
); // true
normalize возвращает новую строку. В этом примере NFC приводит канонически эквивалентные записи к общей форме.
Поддерживаются формы NFC, NFD, NFKC и NFKD. Если аргумент не передан, используется NFC. Формы с буквой K учитывают совместимость и могут сглаживать дополнительные различия представления.
Выбор формы должен соответствовать задаче. Для ключа поиска и для сохранения исходного написания требования могут различаться. Если оригинальный ввод нужен пользователю, полезно хранить его отдельно от производного ключа сравнения.
Нормализация не является универсальным способом приравнять всё визуально похожее. Она не заменяет правила регистра, обработки пробелов, транслитерации или допустимых символов. Такие преобразования нужно выбирать и проверять отдельно.
Проверьте обе формы одного символа, уже нормализованную строку и пример, который по требованиям должен остаться отличным. Если код объединяет записи в коллекции или строит ключи, убедитесь, что одинаковое правило применяется к обеим сторонам сравнения.
Работу со строками и коллекциями можно разобрать на курсах JavaScript. Выбрать правила сравнения для интерфейса поможет ментор по JavaScript.