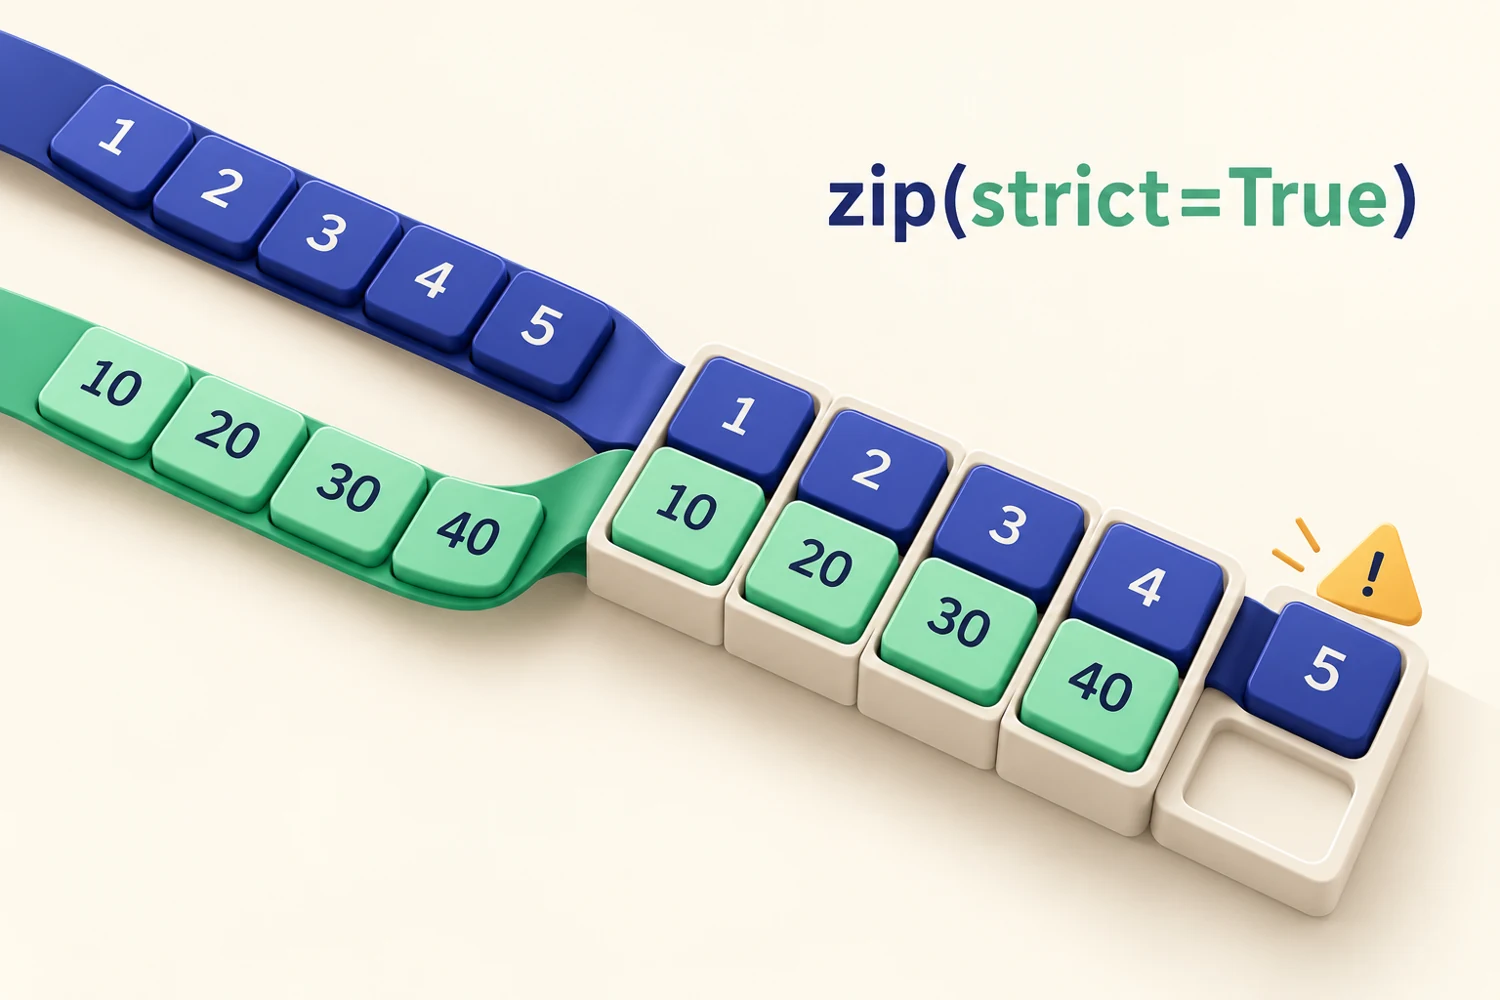
zip берёт по одному элементу из нескольких итерируемых объектов и выдаёт кортежи. По умолчанию он останавливается на самом коротком входе. Если длины обязаны совпадать, используйте strict=True в Python 3.10 и новее. Если нужно сохранить длинный вход с заполнением пропусков, подходит itertools.zip_longest.
Разберём на Mentoring.digital учебную задачу: сопоставить названия товаров и количества. Главный вопрос здесь не синтаксис цикла, а правило обработки неполных данных.
names = ["book", "pen", "folder"]
quantities = [2, 5]
pairs = list(zip(names, quantities))
print(pairs)
# [('book', 2), ('pen', 5)]
Для folder нет количества. Обычный zip молча завершает обход и не выдаёт третью пару. Такое поведение корректно, если вы специально хотите обработать только общую часть. Для импорта заказов оно может скрыть неполную выгрузку.
Результат zip является итератором. Пары формируются при обходе, а не при вызове функции. После полного обхода тот же объект не начнёт выдавать элементы заново. Создайте новый zip или заранее сохраните конечный результат в список, если объём позволяет.
names = ["book", "pen", "folder"]
quantities = [2, 5]

try:
    pairs = list(zip(names, quantities, strict=True))
except ValueError:
    print("Число названий и количеств различается")
else:
    print(pairs)
Исключение появляется во время обхода, когда один из входов заканчивается раньше другого. Само создание zip(names, quantities, strict=True) ещё не проверяет длины. Оба пустых входа допустимы и дают пустой результат.
Если внутри цикла вы сразу отправляете строки в базу или внешний сервис, первые пары могут быть обработаны до ошибки. strict не откатывает эти действия. Для небольшого конечного набора сначала полностью сформируйте и проверьте пары, а затем выполняйте запись. Для больших потоков нужен отдельный порядок валидации и согласованный механизм транзакций.
from itertools import zip_longest

missing = object()
rows = list(zip_longest(names, quantities, fillvalue=missing))
for name, quantity in rows:
    if name is missing or quantity is missing:
        print("Неполная строка")
    else:
        print(name, quantity)
zip_longest работает до исчерпания самого длинного входа. Уникальный объект-маркер позволяет отличить пропуск от допустимого значения None. Проверяйте маркер через is. Если один вход бесконечный, обход без дополнительного ограничения тоже не завершится.
zip.zip(..., strict=True).zip_longest.Проверьте равные длины, короткий первый вход, короткий второй, два пустых списка и один пустой. Затем замените списки генераторами: выбранное правило должно остаться тем же, хотя заранее получить длину генератора нельзя.
Эту практику можно включить в обучение Python на задачах с данными. Сложный импорт с частичной обработкой полезно разобрать с ментором по Python.