30 октября 2026 года AWS добавила разделение GPU для endpoint реального времени в SageMaker AI. Несколько моделей, размещённых через inference components, могут использовать разные аппаратные разделы одного ускорителя. Mentoring.digital объясняет, кому пригодится эта возможность и какие ограничения влияют на план развёртывания.
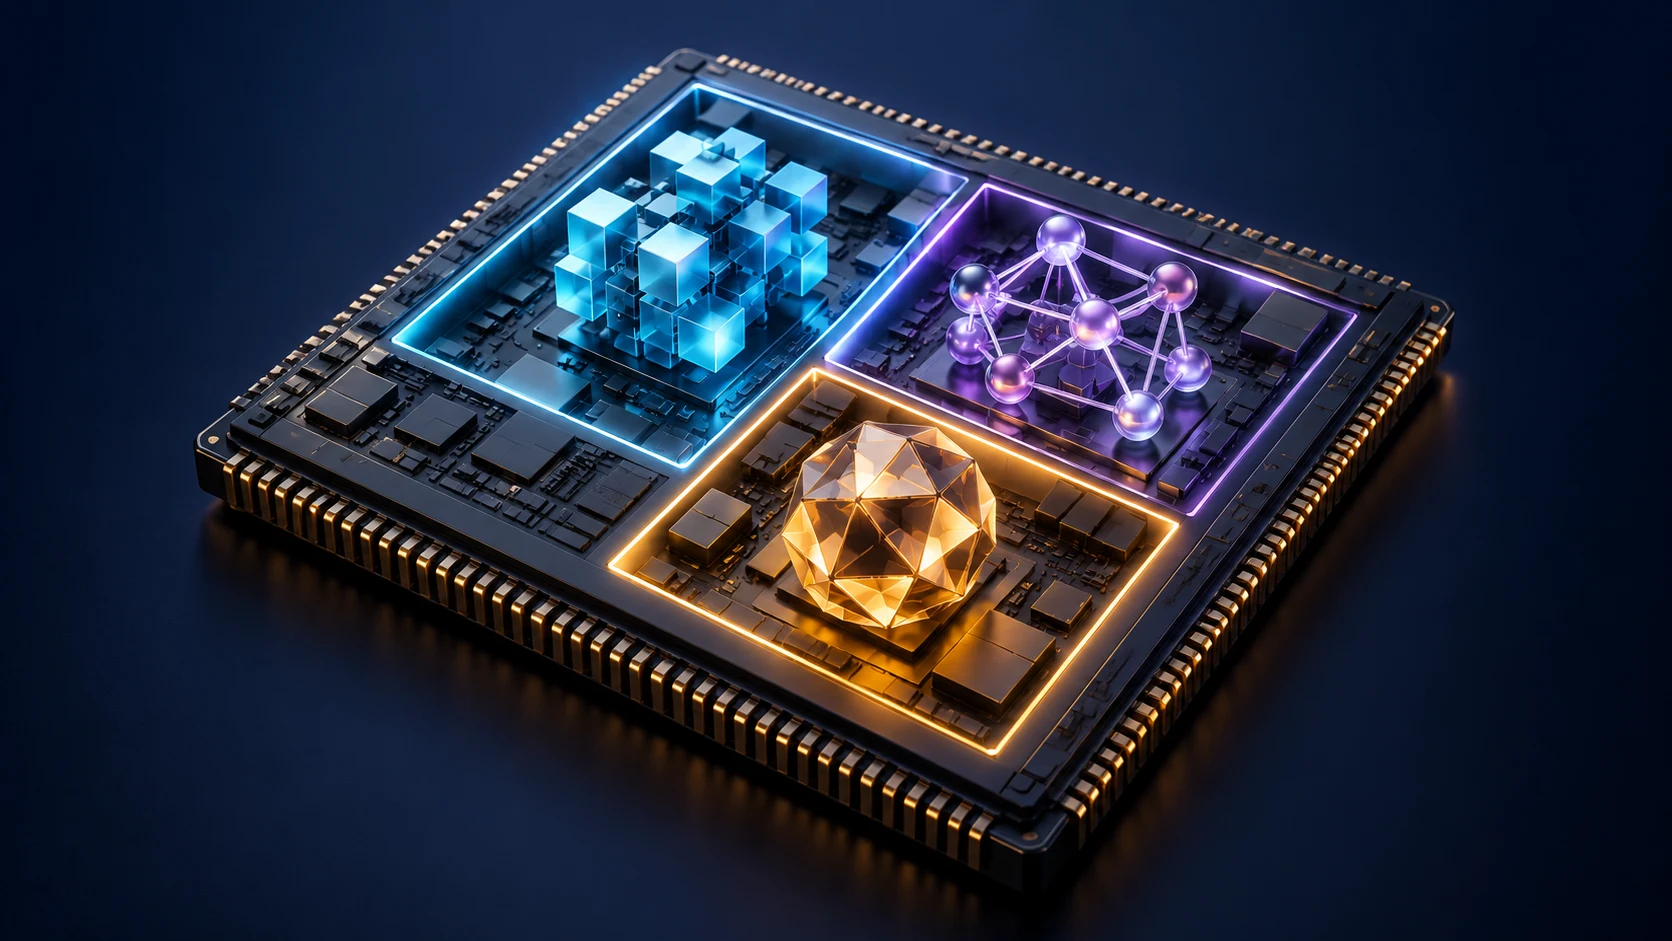
Функция использует NVIDIA Multi-Instance GPU, или MIG. Каждый раздел получает фиксированную долю вычислительных ресурсов и собственную область памяти GPU. Inference component связывает размещённую модель с выбранным типом раздела; вызывать модель по-прежнему можно по имени компонента.
Это может пригодиться, если отдельная модель не требует целого ускорителя. Например, кандидатами для проверки могут стать небольшие модели классификации или построения эмбеддингов. Но само объединение моделей на GPU не доказывает экономию: нужны измерения на собственной нагрузке.
Изоляция касается GPU. Процессор хоста, оперативная память, хранилище и сеть остаются общими. Поэтому разделы не следует воспринимать как полностью независимые серверы.
Разметка ускорителей задаётся при создании endpoint. Для другой схемы потребуется новый endpoint; попытка обновить действующий через UpdateEndpoint с отличающейся разметкой вернёт ошибку 400. Значит, подбор размеров разделов нужно включить в подготовку, а переход заранее продумать отдельно.
Поддержка заявлена для семейств P4d, P5, G7 и G7e в семи регионах AWS. Число и размеры разделов зависят от GPU. В анонсе указан максимум до семи разделов, но он не относится к любой модели ускорителя. Перед выбором нужно сверить тип инстанса, регион и доступную квоту.
В CloudWatch доступны показатели обращений и задержки. При этом разделённые endpoint и их inference components не публикуют метрики утилизации GPU, CPU и памяти. Поэтому прежний набор графиков может оказаться недостаточным для оценки размещения.
Подобрать воспроизводимый сценарий измерений поможет наставник по Machine Learning. Речь идёт о выдаче предсказаний в реальном времени, а не об ускорении обучения моделей: новость не следует смешивать с возможностями SageMaker HyperPod.